Tres servidores MariaDB activo-activo: Galera, HAProxy y la letra pequeña
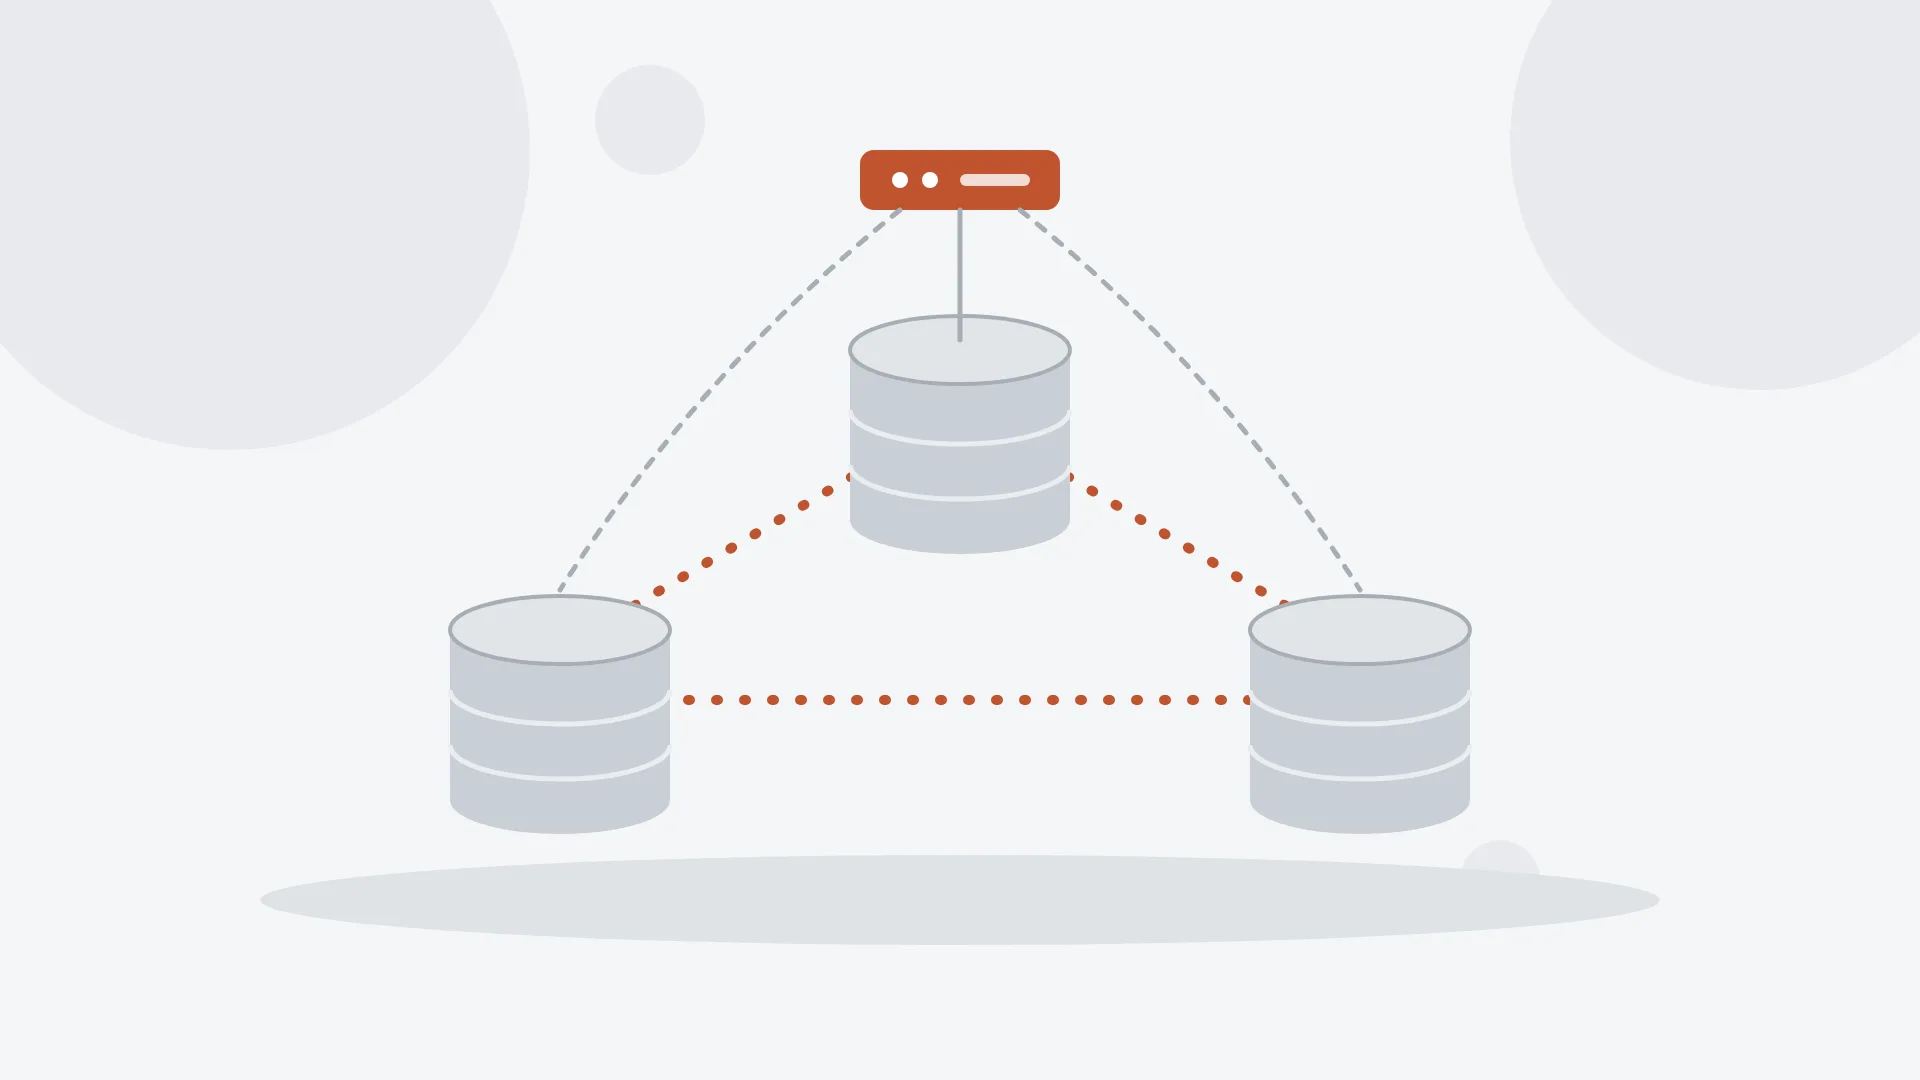
Hace unas semanas conté por qué este blog no tiene base de datos. Hoy toca lo contrario: no una, sino tres, y las tres aceptando escrituras a la vez. «Tres servidores MariaDB en activo-activo, elige tú la tecnología» suena a petición sencilla, y esconde más decisiones de las que parece.
En mayo publiqué una guía paso a paso de Galera en Debian 13, y antes repasé la replicación en MariaDB desde cero. Este post no repite aquello: va de por qué Galera y no otra cosa, de lo que significa de verdad escribir en tres nodos a la vez, de qué poner delante para que la aplicación no se entere de las caídas y de cómo levantar el clúster cuando se apaga entero, que es el día en que más se suda.
Las opciones que hay sobre la mesa
«Activo-activo» quiere decir que cualquier nodo acepta escrituras y que, si uno cae, los demás siguen sin que nadie promueva nada a mano. Con esa definición, el abanico se estrecha rápido:
| Opción | ¿Escribe en varios nodos? | Si cae un nodo, ¿se pierde algo? | ¿Es de MariaDB? |
|---|---|---|---|
| Primario-réplica asíncrona | No | Lo que no hubiera llegado a la réplica | Sí |
| Primario-réplica semisíncrona | No | Mucho menos probable | Sí |
| Circular o multi-source | En teoría | Sí, y los conflictos no los resuelve nadie | Sí |
| Galera Cluster | Sí | No: el commit se certifica en todos | Sí, integrado |
| Group Replication / InnoDB Cluster | Sí | No | No, es de MySQL |
| Gestionada (RDS Multi-AZ y similares) | No | No | Sí, pero no es activo-activo |
La replicación clásica es estupenda para lo que es: un primario que escribe y réplicas que leen. Pero cuando el primario cae, alguien —una persona o una herramienta externa— tiene que elegir el nuevo y reapuntar todo. La semisíncrona reduce la ventana de pérdida, no ese problema. Es activo-pasivo con buena voluntad.
La replicación circular o el multi-source con varios primarios escribiendo es la trampa clásica: si dos nodos modifican la misma fila casi a la vez, cada uno aplica su cambio y luego el del otro, y acabas con datos distintos en cada nodo sin un solo error que te avise. No lo montaría.
Group Replication e InnoDB Cluster son buenas, pero son de MySQL; MariaDB no las implementa, y los dos proyectos llevan años divergiendo, como conté en MySQL y MariaDB, MariaDB y MySQL. Las gestionadas te quitan la operación, pero lo habitual es un primario con un standby síncrono que no atiende tráfico: alta disponibilidad, sí; activo-activo, no.
Queda Galera: replicación síncrona multi-master integrada en MariaDB con el proveedor galera-4. Un paquete y un puñado de variables. Es la que elijo. Con letra pequeña.
Galera en dos minutos: certificación
Una transacción en Galera se ejecuta en el nodo al que estás conectado, sin hablar con nadie. En el COMMIT, el nodo empaqueta las filas que ha tocado (el write-set) y lo difunde a los demás con un orden global. Cada nodo certifica ese write-set: comprueba si choca con otro anterior que tocara las mismas claves. Si no choca, se confirma en todos; si choca, gana el que llegó primero y el otro se aborta. Dos consecuencias:
- El commit es síncrono; la aplicación, no del todo. Cuando tu
COMMITdevuelve OK, la transacción está certificada en los tres y no se va a perder, pero los otros dos pueden tardar unos milisegundos en aplicarla. Si una lectura inmediata en otro nodo no puede permitirse ver el dato viejo, existewsrep_sync_wait, a cambio de latencia. - Los conflictos aparecen en el
COMMIT, no en elUPDATE, y lo hacen comoERROR 1213 (40001): Deadlock found when trying to get lock.
La letra pequeña del «activo-activo»
Al validar la configuración de este post en tres contenedores hice la prueba obvia: una transacción en el nodo 1 resta 30 euros a una fila y espera tres segundos antes del COMMIT; mientras, el nodo 2 suma 50 euros a la misma fila y confirma.
db2: UPDATE ... euros = euros + 50  -> OK, saldo 150
db1: COMMIT                         -> ERROR 1213 (40001): Deadlock found
                                       when trying to get lock; try restarting transaction
Ningún dato divergente: ganó quien certificó primero. Pero con un solo servidor ese error no existiría; el segundo UPDATE habría esperado al bloqueo del primero. En Galera los bloqueos de fila no cruzan nodos; el conflicto se descubre al certificar.
Con filas frías apenas pasa. Con filas calientes —un contador, un stock, un saldo, la tabla de sesiones—, escribir desde los tres nodos dispara los abortos, y cada uno es una transacción que tu aplicación tiene que reintentar. Por eso mucha gente acaba con un único escritor y lecturas repartidas entre los tres: sigue habiendo commit síncrono, cero pérdida y failover automático, solo que las escrituras entran por un nodo. Es también lo que recomienda la documentación de MariaDB para la mayoría de cargas.
Mi criterio: escribe en los tres si tus escrituras tocan filas distintas casi siempre y tu código reintenta ante un 1213 (debería hacerlo de todos modos). Y no lo hagas para ganar capacidad: cada nodo acaba aplicando todas las escrituras, así que repartirlas no la multiplica. Escribe en uno en cualquier otro caso. Y mídelo: wsrep_local_cert_failures y wsrep_local_bf_aborts cuentan las transacciones locales que perdieron una certificación o fueron abortadas por una replicada.
La guía deja las dos puertas abiertas: un puerto de escrituras hacia un único nodo y otro repartido entre los tres.
Topología
| Máquina | IP | Papel |
|---|---|---|
db1, db2, db3 |
10.10.0.11 a 10.10.0.13 |
MariaDB + Galera |
lb1, lb2 |
10.10.0.21, 10.10.0.22 |
HAProxy + keepalived |
| VIP | 10.10.0.10 |
Donde se conecta la aplicación |
Entre los nodos de base de datos: 3306/tcp (clientes), 4567/tcp y udp (replicación), 4568/tcp (transferencia incremental, IST) y 4444/tcp (transferencia completa, SST). Desde los balanceadores, el 3306 y el 9200 del health check. Nada de eso, visible fuera de la red privada.
Qué versión instalar
MariaDB mantiene hoy cuatro LTS: 10.11, 11.4, 11.8 y la 12.3, estable desde el 28 de mayo de 2026 y con soporte hasta junio de 2029. Debian 13 «trixie» trae la 11.8 (11.8.6-0+deb13u1 al escribir esto), también LTS, con soporte hasta junio de 2028, y galera-4 26.4.23.
Me quedo con el paquete de Debian: parches de seguridad por el mismo canal que el resto del sistema, galera-4, socat y rsync resueltos como dependencias y una serie que se mantiene hasta 2028. Si necesitas la 12.3, el post de mayo explica el repo oficial y lo de aquí aplica igual.
En los tres nodos:
sudo apt update
sudo apt install mariadb-server mariadb-backup galera-4
Debian arranca MariaDB al instalarlo, todavía como servidor independiente. Aprovecho en db1, y solo ahí, para crear con sudo mariadb los usuarios del SST y de las copias; los otros nodos los recibirán con la primera copia completa:
CREATE USER 'sst'@'localhost' IDENTIFIED BY 'una-clave-larga-de-verdad';
GRANT RELOAD, PROCESS, LOCK TABLES, BINLOG MONITOR ON *.* TO 'sst'@'localhost';

CREATE USER 'backup'@'localhost' IDENTIFIED BY 'otra-clave-larga';
GRANT RELOAD, PROCESS, LOCK TABLES, BINLOG MONITOR ON *.* TO 'backup'@'localhost';
Son los privilegios que pide la documentación de mariadb-backup. Después, sudo systemctl stop mariadb en los tres.
Configuración de los nodos
Debian trae un /etc/mysql/mariadb.conf.d/60-galera.cnf con todo comentado. Lo sustituyo por esto, cambiando en cada nodo solo las dos líneas de identidad:
[galera]
wsrep_on                 = ON
wsrep_provider           = /usr/lib/galera/libgalera_smm.so
wsrep_cluster_name       = "produccion"
wsrep_cluster_address    = "gcomm://10.10.0.11,10.10.0.12,10.10.0.13"

# Identidad: cambia en cada nodo
wsrep_node_address       = "10.10.0.11"
wsrep_node_name          = "db1"

# Transferencia de estado completa con mariadb-backup
wsrep_sst_method         = mariabackup
wsrep_sst_auth           = "sst:una-clave-larga-de-verdad"

# Requisitos de Galera
binlog_format            = ROW
default_storage_engine   = InnoDB
innodb_autoinc_lock_mode = 2

# Rechaza tablas sin clave primaria y motores que no replican
wsrep_mode               = REQUIRED_PRIMARY_KEY,STRICT_REPLICATION

# Debian trae 127.0.0.1 en 50-server.cnf; este fichero se lee después
bind-address             = 0.0.0.0
innodb_autoinc_lock_mode = 2 es obligatorio para que los AUTO_INCREMENT no serialicen las escrituras aplicadas en paralelo. Y wsrep_mode es la línea que más disgustos ahorra: con ella, una tabla sin clave primaria o en MyISAM devuelve ERROR 4165: Galera replication not supported. Sin ella, comprobé que la tabla MyISAM se crea en los tres nodos, pero sus filas se quedan solo en el nodo donde las insertas.
Arranque: uno con galera_new_cluster, el resto normal
Un clúster nuevo nace en un único nodo. En db1:
sudo galera_new_cluster
El script escribe --wsrep-new-cluster en un fichero de entorno que lee la unit de systemd, reinicia el servicio y borra el fichero. Es de un solo uso, y está bien: en mis pruebas con contenedores, donde dejé ese flag fijo, el nodo se negó a arrancar cuando el clúster ya existía, porque no era seguro hacer bootstrap desde él. Mejor eso que dos clústeres.
En db2 y luego en db3, sudo systemctl start mariadb. Cada uno pedirá un SST, recibirá una copia completa vía mariadb-backup y se unirá. En cualquier nodo:
SHOW GLOBAL STATUS WHERE Variable_name IN
  ('wsrep_cluster_size', 'wsrep_cluster_status',
   'wsrep_local_state_comment', 'wsrep_ready');
wsrep_local_state_comment  Synced
wsrep_cluster_size         3
wsrep_cluster_status       Primary
wsrep_ready                ON
Escribes en db1 y lo lees en db3. Si insertas desde los tres en una tabla con AUTO_INCREMENT, verás saltos en los ids (1, 4, 5, 6…): es wsrep_auto_increment_control, activo por defecto, que da a cada nodo un desplazamiento distinto. Los huecos son el precio; no los pelees.
El balanceador: HAProxy, ProxySQL o MaxScale
La aplicación necesita un único punto de entrada que sepa qué nodos están sanos. Tres candidatos:
- MaxScale, de MariaDB plc, es el que recomienda su documentación: entiende Galera y separa lecturas de escrituras por consulta. El problema es la licencia: la última versión con código publicado, la 24.02, es BSL 1.1 y solo es gratuita en producción con menos de tres servidores, y las versiones actuales piden una clave de licencia para arrancar. Con tres nodos, estás en terreno de suscripción.
- ProxySQL es GPLv3, va por la serie 3.0 y soporta Galera con escritor único, escritores de reserva y lectores. Muy potente (pool de conexiones, reglas por consulta), pero es otro sistema, con su propia configuración y su propia alta disponibilidad, que operar.
- HAProxy no sabe nada de SQL: reparte conexiones TCP y vigila la salud de los servidores. Debian 13 trae la 3.0.
Elijo HAProxy con keepalived, no por listo, sino por aburrido: décadas en producción, una configuración que cabe en una pantalla y una separación de lecturas y escrituras explícita, porque la aplicación elige puerto. Si un día hace falta pool de conexiones, ProxySQL se añade sin tocar el clúster.
El health check: por qué mysql-check no basta
HAProxy trae option mysql-check, que hace el saludo del protocolo y cierra. Su documentación avisa de que no comprueba la consistencia de la base de datos, y en Galera eso importa. Lo probé congelando dos nodos para dejar al tercero sin quórum: seguía aceptando conexiones, mysql-check lo daba por bueno y cada consulta acababa en ERROR 1047 (08S01): WSREP has not yet prepared node for application use.
Hay que preguntar si el nodo está Synced, es decir, si wsrep_local_state vale 4, como hacía el viejo clustercheck con xinetd. Yo lo hago con un script y activación por socket de systemd. En cada nodo, /usr/local/bin/galera-check:
#!/bin/bash
# 200 si el nodo está Synced (wsrep_local_state = 4); 503 en cualquier otro caso
read -r -t 1 _ || true
state=$(mariadb -NBe "SHOW GLOBAL STATUS LIKE 'wsrep_local_state'" 2>/dev/null | awk '{print $2}')
if [ "$state" = "4" ]; then
    printf 'HTTP/1.1 200 OK\r\nContent-Type: text/plain\r\nConnection: close\r\nContent-Length: 7\r\n\r\nSynced\n'
else
    printf 'HTTP/1.1 503 Service Unavailable\r\nContent-Type: text/plain\r\nConnection: close\r\nContent-Length: 11\r\n\r\nNot synced\n'
fi
Se conecta como un usuario de sistema autenticado por unix_socket, sin contraseñas en ningún fichero. El CREATE USER basta lanzarlo en un nodo, porque Galera replica las sentencias de cuentas:
sudo useradd --system --shell /usr/sbin/nologin galeracheck
sudo chmod 755 /usr/local/bin/galera-check
sudo mariadb -e "CREATE USER 'galeracheck'@'localhost' IDENTIFIED VIA unix_socket;"
Las units: /etc/systemd/system/galera-check.socket…
[Unit]
Description=Health check de Galera para HAProxy

[Socket]
ListenStream=9200
Accept=yes

[Install]
WantedBy=sockets.target
…y /etc/systemd/system/galera-check@.service:
[Unit]
Description=Health check de Galera (conexión %i)

[Service]
ExecStart=/usr/local/bin/galera-check
User=galeracheck
StandardInput=socket
StandardOutput=socket
StandardError=journal
sudo systemctl daemon-reload
sudo systemctl enable --now galera-check.socket
curl -s http://10.10.0.11:9200/    # Synced
systemd escucha en el 9200 y lanza una instancia del script por conexión. Si para ti systemd es solo systemctl start, aquí tienes otra cosa que hace gratis.
HAProxy
En lb1 y lb2, apt install haproxy keepalived y este /etc/haproxy/haproxy.cfg:
global
    log /dev/log local0
    maxconn 4096
    user haproxy
    group haproxy
    daemon

defaults
    mode    tcp
    log     global
    option  tcplog
    timeout connect 5s
    timeout client  30m
    timeout server  30m

# Escrituras: un único nodo activo; los otros dos esperan de reserva
listen mariadb-escritura
    bind 10.10.0.10:3306
    option httpchk
    http-check expect status 200
    default-server port 9200 inter 2s fall 3 rise 2 on-marked-down shutdown-sessions
    server db1 10.10.0.11:3306 check
    server db2 10.10.0.12:3306 check backup
    server db3 10.10.0.13:3306 check backup

# Lecturas: repartidas entre los tres
listen mariadb-lectura
    bind 10.10.0.10:3307
    balance leastconn
    option httpchk
    http-check expect status 200
    default-server port 9200 inter 2s fall 3 rise 2 on-marked-down shutdown-sessions
    server db1 10.10.0.11:3306 check
    server db2 10.10.0.12:3306 check
    server db3 10.10.0.13:3306 check
Con backup, las escrituras van a db1 mientras esté sano; si cae, a db2, y después a db3. on-marked-down shutdown-sessions corta las conexiones contra un nodo que deja de estar Synced, para que la aplicación reconecte en vez de quedarse colgada.
Ojo a la vuelta: cuando db1 se recupera, las conexiones nuevas regresan a él mientras las viejas siguen en db2. Durante ese rato hay dos escritores, algo legal en Galera que solo sube la probabilidad de algún 1213. Existe on-marked-up shutdown-backup-sessions para matar las sesiones de reserva cuando vuelve el principal, pero la propia documentación de HAProxy advierte de que puede dejar transacciones a medias.
Como el bind es a la IP virtual, el balanceador que no la tenga necesita permiso para escuchar en ella:
echo 'net.ipv4.ip_nonlocal_bind = 1' | sudo tee /etc/sysctl.d/99-haproxy.conf
sudo sysctl --system
keepalived para la IP virtual
keepalived mueve 10.10.0.10 entre lb1 y lb2 por VRRP. En lb1, /etc/keepalived/keepalived.conf:
global_defs {
    enable_script_security
    script_user root
}

vrrp_script chk_haproxy {
    script "/usr/bin/systemctl is-active --quiet haproxy"
    interval 2
    fall 2
    rise 2
}

vrrp_instance VI_MARIADB {
    state BACKUP
    interface eth0
    virtual_router_id 51
    priority 150
    advert_int 1
    virtual_ipaddress {
        10.10.0.10/24
    }
    track_script {
        chk_haproxy
    }
}
En lb2, igual con priority 100. Si HAProxy muere en lb1, lb2 se queda con la IP en un par de segundos. La aplicación escribe en 10.10.0.10:3306, lee en 10.10.0.10:3307 y no sabe nada más.
Quórum, split-brain y por qué tres
Galera solo deja escribir al grupo que conserva más de la mitad de los votos: el componente primario. Con tres nodos, perder uno deja dos de tres y todo sigue. Con dos, perder uno deja uno de dos, que no es mayoría, y el superviviente se bloquea. Si solo tienes dos servidores de verdad, el tercer voto puede ser garbd, el árbitro de Galera: un demonio sin datos que en Debian viene en galera-arbitrator-4 y cabe en una máquina minúscula.
Un nodo sin quórum pasa a non-Primary y rechaza las consultas con el ERROR 1047 de antes. Es una protección: impide que dos mitades de una red partida acepten escrituras distintas. Por eso pc.ignore_quorum y pc.ignore_sb, que permiten seguir escribiendo sin mayoría, no se tocan: la documentación pide cuidado con la primera y avisa de que la segunda, en un clúster multi-master, puede dejar datos inconsistentes.
Si una partición te deja sin primario en ningún lado, eliges un lado y fuerzas allí un nuevo primario. Un detalle que la documentación no refleja bien: en la 11.8, tanto en el paquete de Debian como en la imagen oficial, viene activo el plugin wsrep_provider, que expone cada opción del proveedor como variable propia y deja wsrep_provider_options en solo lectura. El clásico SET GLOBAL wsrep_provider_options='pc.bootstrap=YES' da error. Lo que funciona:
SET GLOBAL wsrep_provider_pc_bootstrap = ON;
Nunca en los dos lados: tendrías dos clústeres divergentes sin forma limpia de juntarlos.
Cuando se apaga todo
Un corte de luz y los tres nodos abajo. Al volver, ninguno sabe si tiene los datos más recientes. La pista está en /var/lib/mysql/grastate.dat. Tras un apagado ordenado, el último nodo en pararse lo indica:
# GALERA saved state
version: 2.1
uuid:    1aa23554-c03c-11f1-90ae-6f74d9101531
seqno:   16
safe_to_bootstrap: 1
Desde ese se hace galera_new_cluster. Desde otro, Galera se niega: It may not be safe to bootstrap the cluster from this node.
Tras un crash, todos tienen seqno: -1 y safe_to_bootstrap: 0, y hay que preguntarle a InnoDB. Con MariaDB parado, en cada nodo, sudo galera_recovery, que arranca mariadbd con --wsrep-recover e imprime la última transacción confirmada. En una prueba en la que maté db3, seguí escribiendo y luego maté los otros dos de golpe:
db1: --wsrep_start_position=1aa23554-c03c-11f1-90ae-6f74d9101531:22
db2: --wsrep_start_position=1aa23554-c03c-11f1-90ae-6f74d9101531:22
db3: --wsrep_start_position=1aa23554-c03c-11f1-90ae-6f74d9101531:19
Gana el seqno más alto (tras los dos puntos); si empatan, cualquiera. En el elegido:
sudo sed -i 's/^safe_to_bootstrap: 0/safe_to_bootstrap: 1/' /var/lib/mysql/grastate.dat
sudo galera_new_cluster
# en los otros dos, cuando el primero esté Synced:
sudo systemctl start mariadb
Los demás se sincronizan con IST si el hueco cabe en la caché de escrituras (gcache.size, 128 MB por defecto) o con un SST completo si no. Apunta este procedimiento en algún sitio que no sea el propio clúster.
Las limitaciones con las que vas a convivir
- Solo InnoDB y clave primaria en todas las tablas: lo garantiza el
wsrep_modede antes. - Transacciones grandes. El write-set se certifica entero en memoria;
wsrep_max_ws_sizelo limita a 2 GB. La documentación menciona además un tope de 128K filas enwsrep_max_ws_rows, pero en la 11.8 viene a 0, sin límite. LosLOAD DATAyDELETEgigantes, en lotes; para lo inevitable está la streaming replication (wsrep_trx_fragment_size). LOCK TABLESyGET_LOCK()no están soportados.LOCK TABLESni siquiera da error: bloquea solo en el nodo local, que es peor, porque te crees protegido. Usa transacciones ySELECT … FOR UPDATE.- DDL. Por defecto, un
ALTER TABLEva en TOI (Total Order Isolation): se ejecuta en todos los nodos en el mismo punto del orden global y bloquea las escrituras de todo el clúster mientras dura. Para tablas grandes está RSU (SET SESSION wsrep_OSU_method = 'RSU'): el cambio se aplica solo en local, así que sacas el nodo del balanceador, lo alteras, lo devuelves y repites en el siguiente, con un esquema que debe ser compatible hacia atrás mientras conviven los dos. La tercera vía, NBO, es solo de la edición Enterprise.
TLS entre nodos
Galera replica en claro por defecto. Si los nodos cruzan una red que no controlas, cifra: una CA propia, un certificado por nodo y dos bloques más en 60-galera.cnf:
[galera]
# ...lo anterior, más:
wsrep_provider_options = "socket.ssl_cert=/etc/mysql/ssl/db1-cert.pem;socket.ssl_key=/etc/mysql/ssl/db1-key.pem;socket.ssl_ca=/etc/mysql/ssl/ca.pem"

[sst]
encrypt = 3
tkey    = /etc/mysql/ssl/db1-key.pem
tcert   = /etc/mysql/ssl/db1-cert.pem
tca     = /etc/mysql/ssl/ca.pem
El segundo importa: cifrar la replicación no cifra el SST, que es una copia completa de tu base de datos viajando por la red. Forzando un SST, el log mostraba encrypt='3' y OpenSSL sobre socat. Nodos cifrados y sin cifrar no se hablan, así que activarlo después exige reiniciar el clúster entero o tres rondas de reinicios con socket.dynamic. Mejor desde el primer día.
Copias de seguridad
Tres copias idénticas no son un backup: un DROP TABLE llega a los tres en milisegundos. La copia se hace desde un nodo con mariadb-backup, desincronizándolo mientras dura para que no frene al resto vía control de flujo, como recomienda la documentación:
sudo mariadb -e "SET GLOBAL wsrep_desync = ON;"
sudo mariadb-backup --backup --galera-info \
  --target-dir=/var/backups/mariadb/$(date +%F) \
  --user=backup --password='otra-clave-larga'
sudo mariadb -e "SET GLOBAL wsrep_desync = OFF;"
sudo mariadb-backup --prepare --target-dir=/var/backups/mariadb/$(date +%F)
--galera-info guarda la posición del clúster junto a la copia. Y el health check trabaja solo: en Donor/Desynced, wsrep_local_state deja de valer 4 y HAProxy saca el nodo de la rotación hasta que vuelve. Luego esa carpeta tiene que salir de la máquina, por ejemplo con restic.
Lo que me llevo
Para tres servidores MariaDB en activo-activo monto Galera con el paquete de Debian, HAProxy con un health check que mire wsrep_local_state y keepalived para la IP virtual. Dos puertos, escrituras y lecturas, y que la aplicación decida si escribe en uno o en los tres sabiendo lo que implica. wsrep_mode para que el clúster rechace lo que no sabe replicar, SST cifrado si la red no es mía y el procedimiento de arranque en frío escrito antes de necesitarlo.
Lo que no haría es venderlo como «escribes donde quieras y ya»: los conflictos existen, se descubren al confirmar y alguien tiene que reintentar. Vigila wsrep_local_cert_failures, wsrep_local_bf_aborts y wsrep_cluster_size —el exporter de Prometheus los expone— y deja que los números te digan si tu carga aguanta tres escritores.
Este blog sigue sin base de datos. Las tres son para cuando lo que está en juego no es un contador de visitas.